۱۶ آبان ۱۴۰۵
اخبار پزشکی سلامت
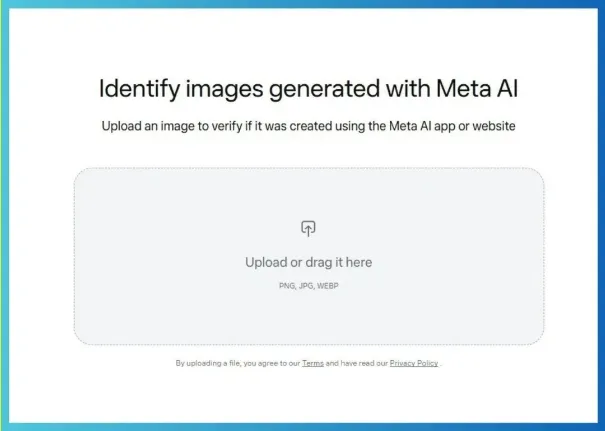
به گزارش مجله خبری نگار/سیتنا،به عنوان کسی که زمان زیادی را صرف بررسی سیستمهای برچسبگذاری هوش مصنوعی میکند، Content Seal اعتماد من را جلب نمیکند. راهحلهای مستقرتری مانند C۲PA Content Credentials و SynthID گوگل وجود دارند که متا میتوانست بهجای راهاندازی سیستم خود با تأخیر قابلتوجه، از آنها استفاده کند. پس از بررسی برای فهمیدن اینکه چرا متا سیستم خود را راهاندازی کرده، متقاعد نشدهام که متا این موضوع را به خوبی اندیشیده است.
بر اساس توضیحات متا، Content Seal مشابه SynthID عمل میکند. واترمارک نامرئی، یک «سیگنال پنهان منبع» را در تصاویر تولیدشده توسط هوش مصنوعی جاسازی میکند که سپس توسط یک ابزار تشخیص قابل اسکن و علامتگذاری است و به کاربران آنلاین کمک میکند تا دیپفیکها را از محتوای معتبر تشخیص دهند. مانند SynthID، متا نیز میگوید که واترمارکهای Content Seal حتی اگر تصویر «برش داده شود، فشرده شود، تغییر اندازه داده شود یا اسکرینشات گرفته شود» دست نخورده باقی میمانند و قابل تشخیص هستند.
اگر Content Seal از نظر عملکردی کار مشابهی انجام میدهد، چرا فقط از SynthID استفاده نکرد؟ متا در حال حاضر به عنوان عضو کمیتهٔ راهبری ائتلاف برای اصالت و منبع محتوا (C۲PA) فعالیت میکند که استاندارد جداگانهٔ Content Credentials را همراه با گوگل ترویج میدهد، بنابراین تمایل خود را برای همکاری با دیگران در حل مسئلهٔ رو به رشد تشخیص هوش مصنوعی نشان داده است. SynthID همچنین توسط OpenAI پذیرفته شده است، بنابراین واضح است که گوگل نیز مایل است فناوری خود را در اختیار ارائهدهندگان رقیب هوش مصنوعی برای بهبود شفافیت قرار دهد.
با وجود شباهتهای این سیستم به سیستم گوگل، Content Seal در وضعیت فعلی خود دارای محدودیتهای متعددی است:
فقط از طریق ابزار تحت وب: کاربران فقط از طریق یک ابزار وب اختصاصی که متا در حال آزمایش آن است، میتوانند واترمارکهای Content Seal را تشخیص دهند، به این معنی که متا قابلیتهای تشخیص را در چتبات Meta AI خود مانند گوگل با Gemini نساخته است.
فقط روی جدیدترین مدلها: واترمارک فقط روی تصاویر تولیدشده توسط Muse در برنامهٔ Meta AI و وبسایت Meta.ai اعمال میشود، بنابراین کاربران نمیتوانند از آن برای تشخیص محتوای ایجادشده توسط مدلهای قدیمیتر متا استفاده کنند.
عدم پشتیبانی از ویدیو: پشتیبانی از ویدیو نیز در دسترس نیست، اگرچه متا میگوید که «به زودی» ارائه خواهد شد.
محدودیت استفاده روزانه: متا محدودیت روزانهای برای تعداد دفعاتی که میتوانید تصاویر را برای Content Seal بررسی کنید، اعمال کرده است که میتواند مانعی برای شفافیت در مقیاس بزرگ باشد.
عدم تشخیص توسط پلتفرمهای دیگر: هنگامی که یک تصویر آزمایشی ساختهشده با Muse را به Gemini و پورتال تشخیص رسمی C۲PA وارد کردم، هیچکدام نتوانستند تأیید کنند که تصویر تولیدشده توسط هوش مصنوعی است.
همچنین این سؤال وجود دارد که آیا Content Seal میتواند در کنار SynthID و Content Credentials روی فایلهای تصویر و ویدیو اعمال شود بدون اینکه با آن استانداردهای دیگر تداخل کند. متا توضیح روشنی در این مورد ارائه نکرده است.
فیث ایشن، سخنگوی متا، گفت: «ما مصمم هستیم با همتایان صنعتی خود همکاری کنیم تا اطمینان حاصل کنیم که کاربران بهترین تجربهٔ ممکن را دارند.» او همچنین گفت: «ما در حال بررسی راههایی هستیم تا تشخیص را به جایی که مردم با محتوای تولیدشده توسط هوش مصنوعی مواجه میشوند، نزدیکتر کنیم.»
با این حال، به نظر میرسد پشتیبانی گستردهتر از این استاندارد هنوز در حال انجام است، که میتواند از برچسبگذاری مؤثر تصاویر تولیدشده توسط Muse در خارج از پلتفرمهای متا جلوگیری کند.
با توجه به اینکه Content Seal فقط میتواند تصاویر تولیدشده با جدیدترین مدل هوش مصنوعی متا را تشخیص دهد، باید پرسید که این شرکت در تمام این مدت چه کرده است. متا از سال ۲۰۲۳ ابزارهای تولید تصویر هوش مصنوعی را ارائه کرده است، بنابراین قبلاً حجم زیادی از محتوای جعلی تولید کرده که توسط سیستم اختصاصی خود قابل تشخیص نیست. همچنین در سال ۲۰۲۳، برچسبهای هوش مصنوعی را در اینستاگرام و فیسبوک معرفی کرد که با برچسب اشتباه عکسهای واقعی به عنوان «ساختهشده توسط هوش مصنوعی»، خشم بسیاری از عکاسان را برانگیخت.
حتی رهبران ارشد متا نیز به نظر میرسد در مورد اینکه قدم بعدی چه باید باشد، سردرگم هستند. آدام موسری، رئیس اینستاگرام، در یک پادکست گفت: «من فکر نمیکنم که ما باید محتوای هوش مصنوعی را فیلتر کنیم» در حالی که تأکید کرد «ما باید به شما اطلاع دهیم که آیا محتوا هوش مصنوعی است یا نه.» موسری همچنین عقیدهٔ قبلی خود را تکرار کرد که ممکن است «عملیتر باشد که رسانهٔ واقعی را انگشتنگاری کنیم تا رسانهٔ جعلی.»
Content Seal هیچ مزیت منحصربهفردی برای مصرفکنندگان نسبت به سیستم مشابه و مستقر SynthID ارائه نمیدهد و در عوض فقط یک مانع دیگر ایجاد میکند که مردم باید برای تأیید محتوای هوش مصنوعی از آن عبور کنند. شاید متا بهتر بود مانند OpenAI، استاندارد واترمارک گوگل را پذیرفته بود.
اگر متا میخواهد روی راهحلهای خود بایستد، به چیزی فراتر از یک کلون ناقص از SynthID نیاز دارد تا ثابت کند که واقعاً در مورد شفافیت هوش مصنوعی جدی است. رویترز نیز قبلاً دریافته است که Content Seal در تشخیص بیش از نیمی از تصاویر تولیدشده توسط Muse که برش داده شده بودند، شکست خورده است.